Claude 模型详解:如何为你的用例选择合适模型
发布日期: 2026年7月24日
分类: Claude 官方博客
来源: https://claude.com/blog/claude-models-explained-choosing-the-best-model-for-your-use-case
建议:先从高能力模型开始
我们最常听到的问题之一是:“这个工作负载该选哪个模型?”随着模型类别和版本增多,答案也更需要结合实际情况判断。
本文介绍各模型类别、选型时应提出的关键问题以及相关最佳实践。但先给出默认建议:从当前公开可用、能力最强的模型开始,再使用 effort level 调整性能与成本。
即使单 token 价格更高,高能力模型在较低 effort level 下的单任务成本往往更低。原因是它们通常以更少轮次和更短思考时间完成大多数任务;若一开始选择较小模型,也更难分辨问题究竟来自模型能力还是部署配置。
当用例对延迟或成本更敏感时,再逐步测试较低层级模型,找到合适的平衡点。也有组织会从最具成本效益的模型开始,逐级上调,直到满足质量门槛;两种方向性方法均见模型选型文档。
Claude 模型家族
Mythos / Fable
Mythos 是 Anthropic 能力最强的模型类别,在多领域具备前沿能力,尤其适合编码、长时间运行的 Agent 任务,以及 AI 此前无法稳定完成的问题。
这一类别基于同一底层模型提供两种包装。Claude Mythos 面向处理网络安全和生物学双重用途工作的受信任组织;Claude Fable 加入了额外安全防护,适合向公众提供。二者均要求有限数据保留,以确保可安全使用。
Opus
Opus 是面向推理密集型企业任务的强大模型类别。在 GDPval-AA 等知识工作基准、Terminal-Bench 2.1 等 Agent 编码基准中,Opus 模型持续位居领先行列。
Opus 与 Fable 都擅长编码、长时间运行 Agent 和知识工作,乍看不易取舍。实际使用中,Fable 这类更大模型即使与 Opus 基准分数相近,通常仍更具判断力、创造力和写作能力。经验法则是:若评测或内部测试显示 Opus 在某类任务上吃力,应选 Fable;若 Opus 已达到质量门槛,其速度和价格特征可能更有优势。
Sonnet
Sonnet 是面向日常任务的通用模型类别,在性能、成本和速度间取得平衡,适用于最广泛的通用场景,也适合作为多 Agent 编排中的高吞吐子 Agent。
Haiku
Haiku 是成本最低、速度最快的模型类别,面向对延迟和成本敏感的高频工作负载。
如何为工作负载选模型
模型类别并非各自专精于某个行业;不会因为是金融任务就固定推荐一种模型、科学任务就推荐另一种。每个 Claude 模型都针对编码、Agent 任务和知识工作进行了训练。
类别之间的主要区别在于:模型能稳定承担多难的问题,以及相应的速度和价格。选型时可问:
任务有多难? 若任务耗时长、步骤多,或此前无法解决,应选能力更高的类别。
延迟要求是什么? 对面向客户的高频场景,Sonnet 往往是合适选择。
访问条件有哪些? Mythos 仅向 Project Glasswing 下的组织提供;组织也未必会向所有角色开放所有模型类别。
单位经济性如何? 产量高时,较低类别可能更合适,前提是评测证明其任务完成质量达标。各模型 token 定价不同,不同能力和 effort level 也会造成不同的单任务成本。
effort level 同样会改变质量、速度和成本的平衡。高类别模型搭配高 effort 提供最佳性能;高类别模型搭配低 effort 有时反而比小模型更高效。
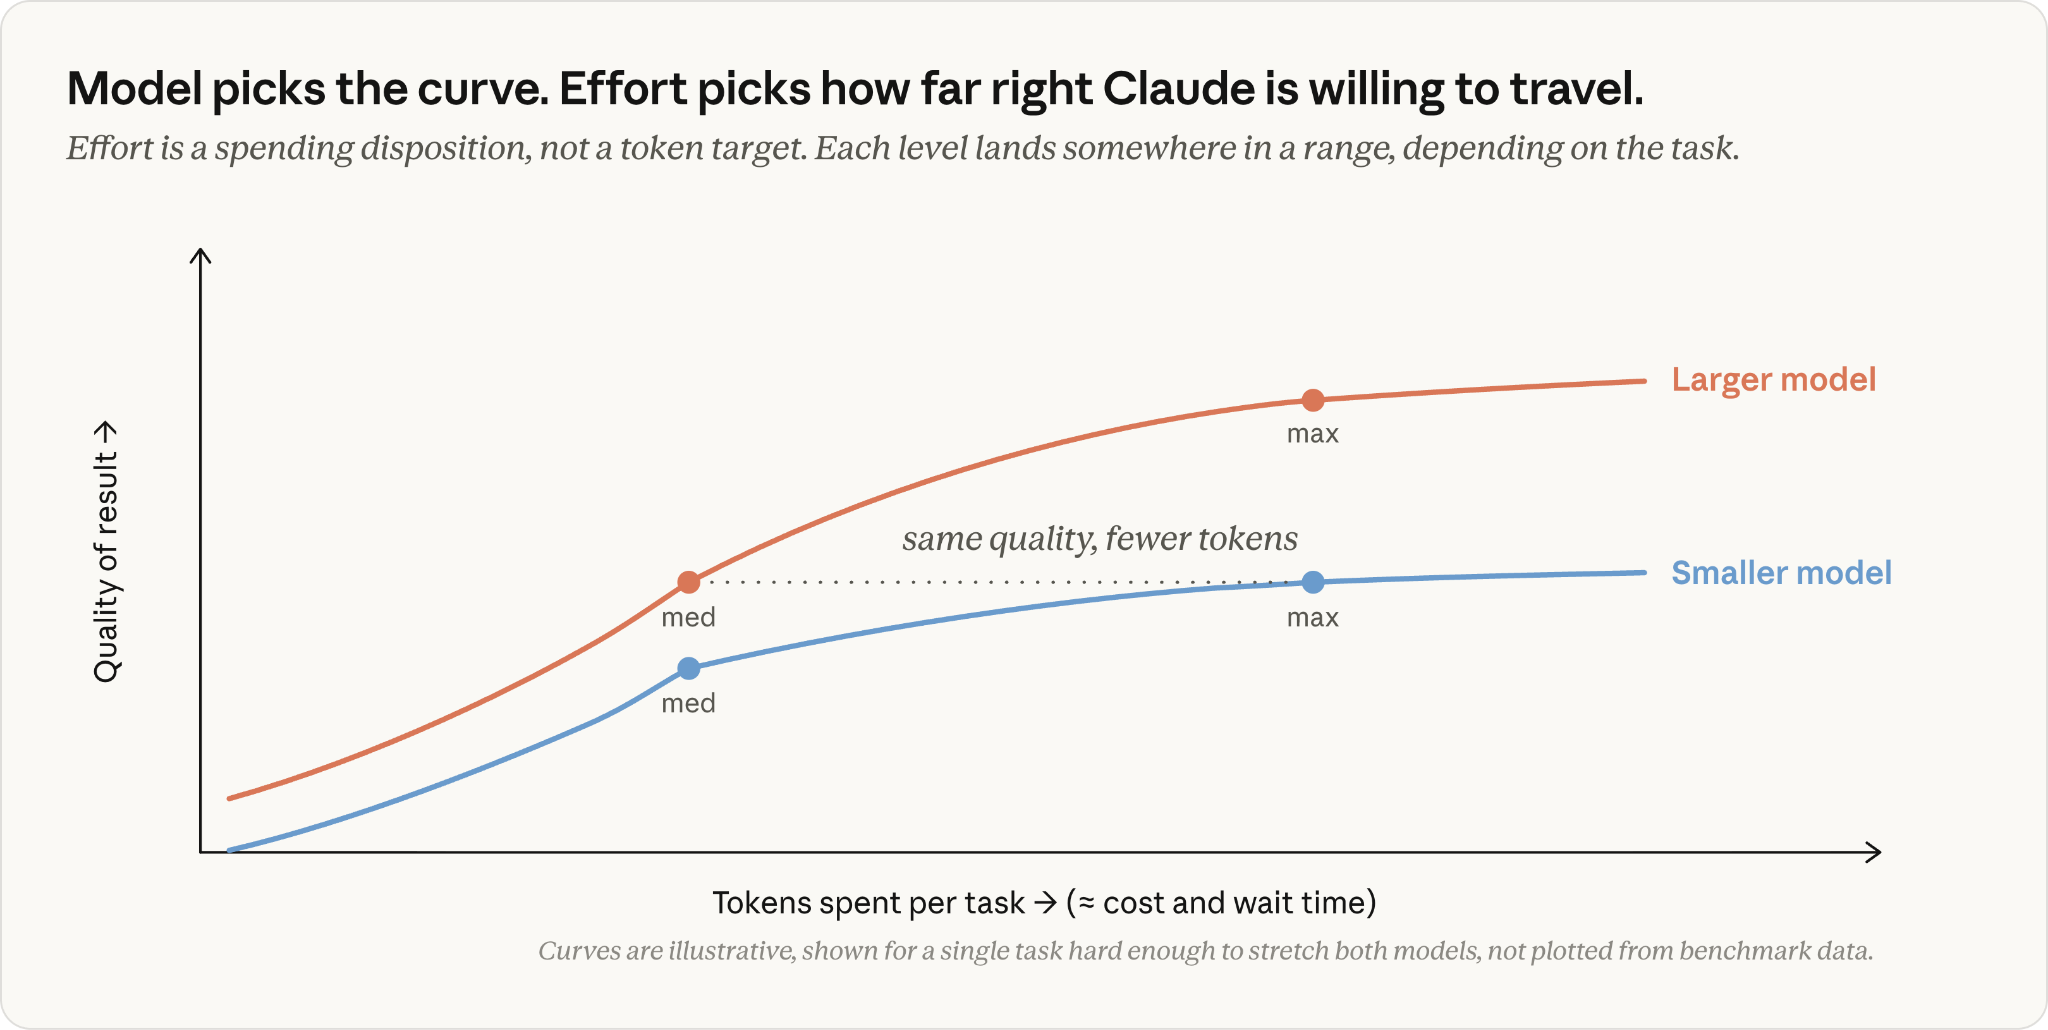
曲线仅用于说明,并非基于 benchmark 数据绘制。
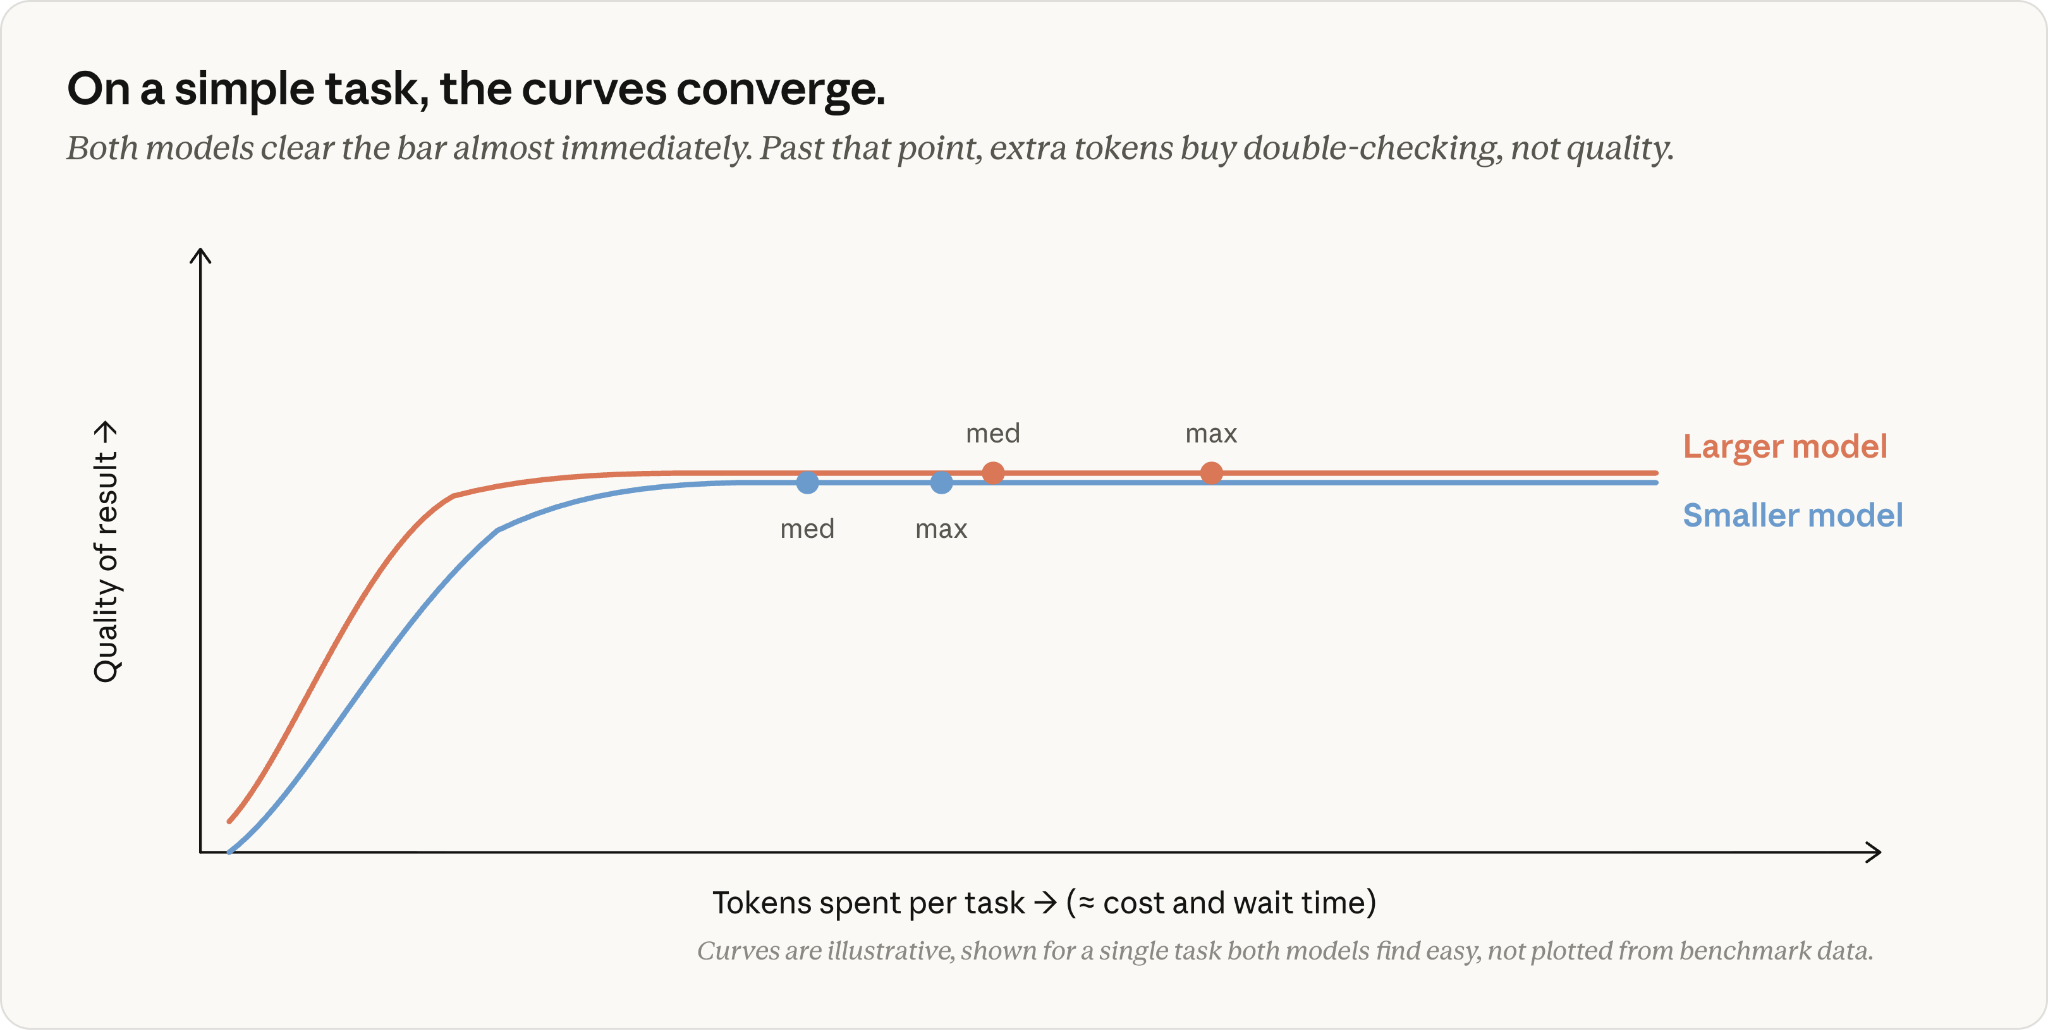
曲线仅用于说明,并非基于 benchmark 数据绘制。更多内容见在 Claude Code 中选择 Claude 模型与 effort level。
用 advisor strategy 组合模型优势
advisor strategy 让更快、成本更低的 worker model 在需要时调用更高能力模型,检查计划并评估工作,从而提高整体表现。
这种只在必要时指导执行模型的方式可显著改善结果。例如在 SWE-bench Pro 上,采用 Fable 5 作为 advisor 的 Sonnet 5,得分距 Fable 5 不到 10%,成本则是全程使用 Fable 5 的 63%。
Eval 与 benchmark 如何帮助选型
判断模型能力是否足够,常见做法是参考标准 benchmark 与自定义 eval。
benchmark 是一组预先设定、通常面向特定领域且有已知答案的任务或场景,可用于横向了解不同模型类别和提供商的能力。对 Opus、Fable 这类强模型,难点在于它们会解决测试中的几乎全部题目,即出现所谓“饱和”。
此时,应在真实工作负载中使用模型,或以自有 eval 进行测试再做决定。通常,eval 是从生产问题中筛选出的任务集合:其中包括现有工具处理不好的难题,以及团队自行定义的成功标准。
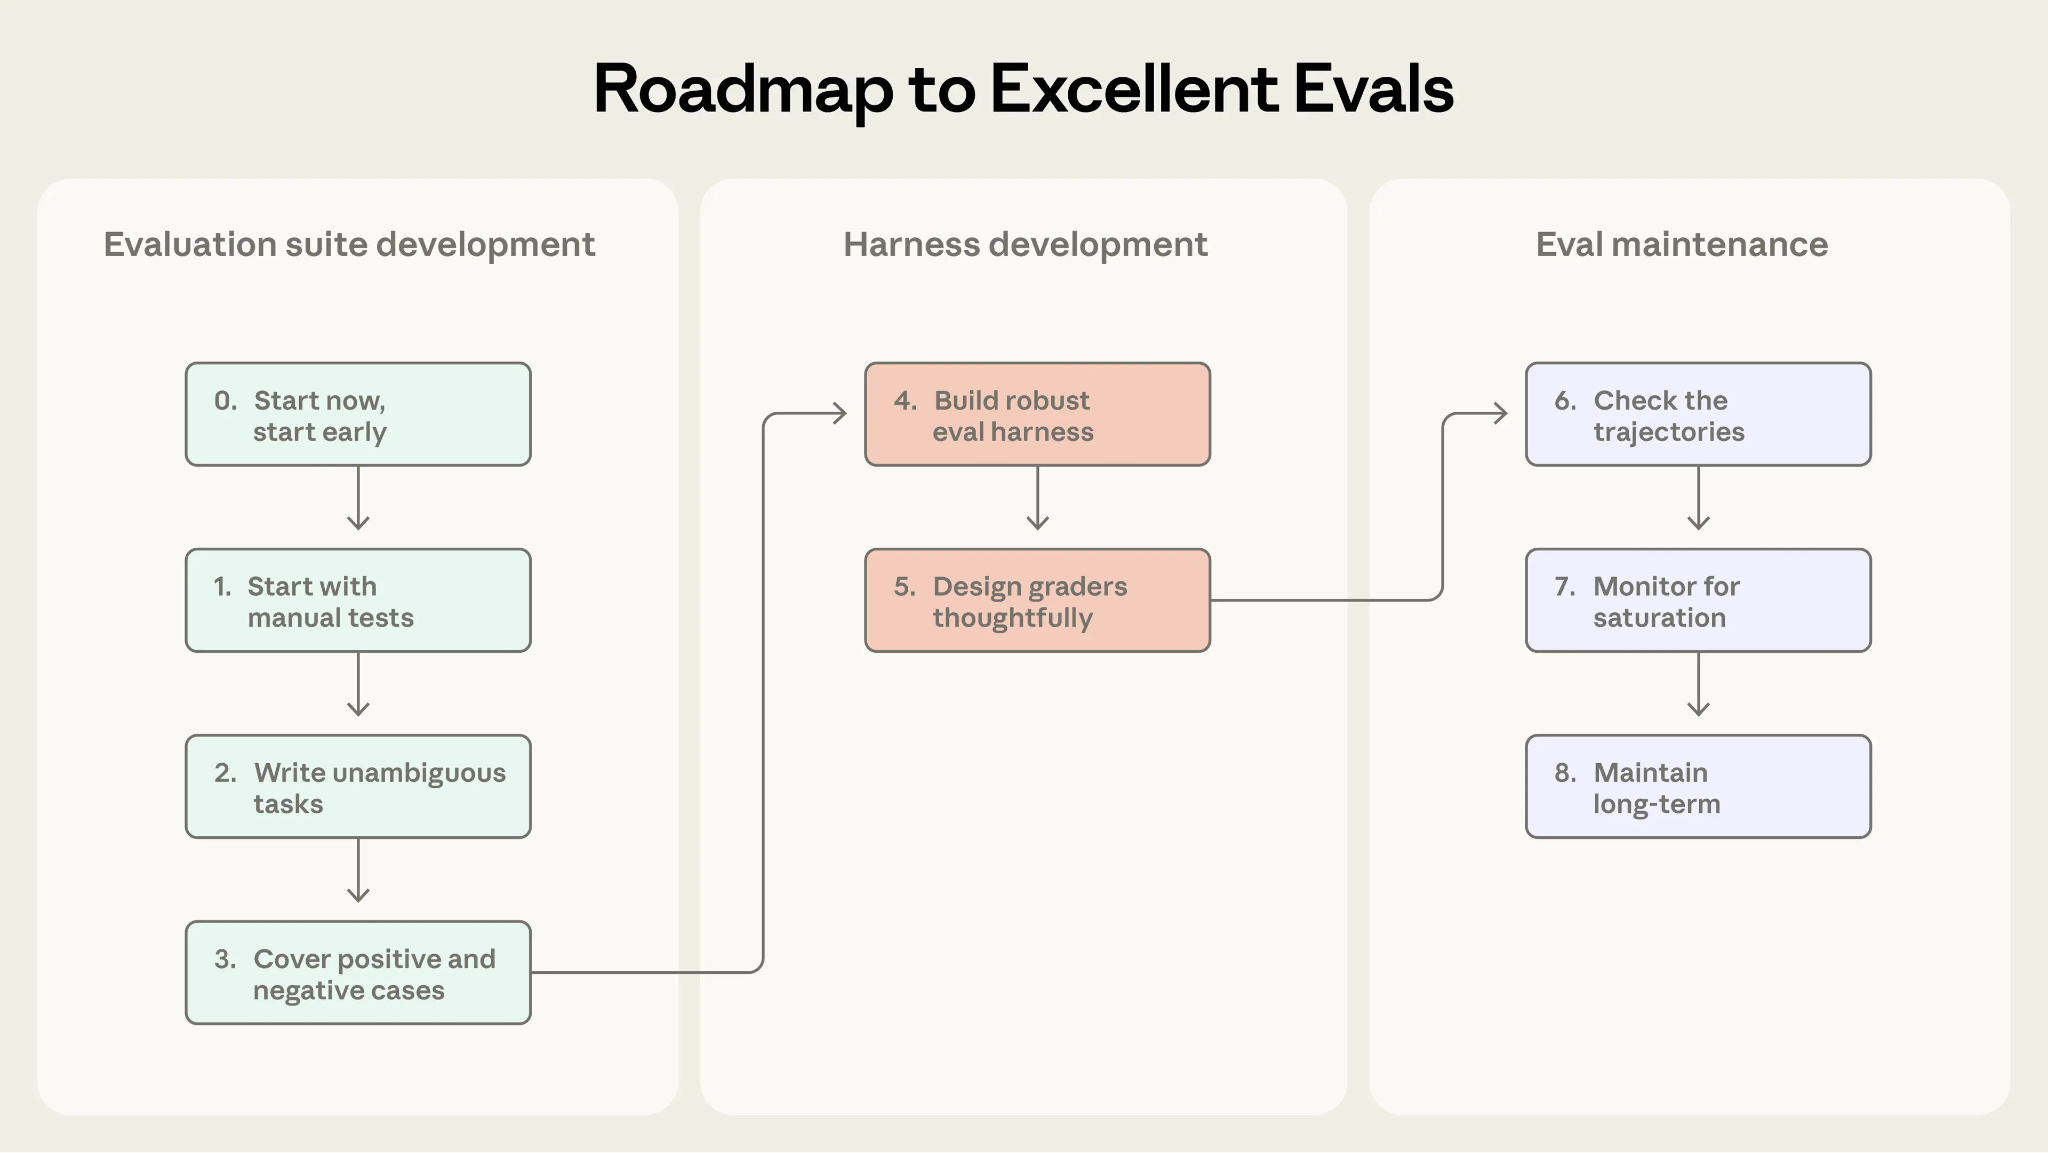
前沿模型的能力与创造力正是在这里开始拉开差距。关于自定义 Agent eval 的实践,Anthropic 已有更深入的说明。
做出明智选择
AI 模型选型没有放之四海而皆准的答案,这正是提供多个模型类别的原因。最终,应理解每个类别的基础特征,也要深入了解自己的用例;这意味着持续构建、维护和部署可靠的 eval。